13.1 一様乱数
本節では, 一様分布に従う乱数 (一様乱数) の生成法を説明する.一様乱数を生成する際には, まず非負整数の区間 [0, m) 上で一様分布に従う整数乱数生成する. 次に, 実数乱数が必要であれば適当な区間の浮動小数点数に変換するのが一般的である.
13.1.1 線形合同法
古くから使われている乱数生成法は線形合同法である.
3 個の非負整数パラメータを a, c および m とし, \(0 \le a < m, 0 \le c < m\) とする. a を乗数, c を増分, m を法とよぶ. 適当な初期値 \(X_0 (0 \le X_0 < m)\) を選び, 次の漸化式により区間 [0, m) の整数列を生成する. \(X_0\) をシードとよぶ. \[ X_{i+1} = (a X_i + c) \space mod \space m \] パラメータ a, c および m を適切に選ぶと乱数列が得られる. この方法では同じシード \(X_0\) からは同じ乱数列が得られる. すなわち, 最長で m の周期で同じ数列を繰り返すことになる.
13.1.1.1 法 m の選び方
乱数生成プログラムとしては周期はできるだけ長い方がよい. ところが周期は m より大きくはならないから, まずはできるだけ大きな m を選びたい.
乱数の生成速度を考えると, 例えば 32 ビット符号なし整数であれば m = \(2^{32}\) (\(2^{ワード長}\)) とするのがよさそうである. そうすると, 時間がかかる演算である mod m のための除算を省くことができる. 例として, C 言語のプログラムを以下に示す (unsigned int 型は 32 ビットのデータとする).
#define A	69069
#define C	4243209856

unsigned int ex_rand(unsigned int *x) {
    *x = *x * A + C;
    return *x;
}
x にシード (初期値) を入れて呼び出せば乱数列を生成する.
コード上では特に mod m の計算を行っていないが, *x * A + C の計算を行ったときに \(2^{32}\) を超えてオーバーフローしても無視して計算を続行するため, 事実上 mod \(2^{32}\) の計算を行っているのと同じになる.
線形合同法で注意すべき点として下位ビットの非ランダム性がある. ここで, d が m の因子であるものとして, 次式が成り立つとする.
\[
Y_n = X_n \space mod \space d
\]
そうすると, 次式も成り立つ.
\[
Y_{n+1} = (a Y_n + c) \space mod \space d
\]
すなわち, 小さな因子 d を持つ m の場合, 乱数列の下位 d ビットは短い周期で同じ値を繰り返すためランダム性が低い.
m = \(2^{32}\) の場合には d = 2, 4, 8, … となりうるから下位数ビットはかなり規則的になる. 特に最終ビットは 0, 1 を繰り返すか 0 または 1 の定数になる.
上の C プログラムでシードを 13 として乱数を生成すると次のようになった. 左から, 生成された乱数, mod 2 とした場合, mod 8 とした場合を示す.
4244107753  1  1
 413715221  1  5
 427421521  1  1
2215051101  1  5
 282686713  1  1
4210462437  1  5
 142691553  1  1
2856139693  1  5
2812793097  1  1
2498959285  1  5
最終ビットは常に 1 となっている. mod 8 でも周期は 2 である.
一方, m として大きな素数を選べば, 下位側も含めてランダムな数列を得ることができそうであるがこれは後で述べる別の問題がある.
しかしながら, 実数乱数 (浮動小数点数 ) に変換して使う場合など, 多くの応用では下位側の規則性は問題にならないため, 実装上は m = \(2^{ワード長}\) がよく使われる. ただし, 使用する側が以上のことを理解しておく必要がある.
13.1.1.2 乗数 a および増分 c の選び方
大きな m を使用したとして, 周期が最長の値 m となるための a と c の選び方の必要十分条件は次のとおりである.
- c と m は互いに素である
- m の素因数 p に対し a = 1 (mod p) である
- m が 4 の倍数のときは a = 1 (mod 4) である
これから, m を素数としたときには, 最長周期 m とする a は 1 のみであることがわかる. これは \(X_{i+1} = (X_i + c) \space mod \space m\) となりランダムな数列にはならない.
線形合同法において c = 0 としたものを乗法合同法とよぶ.
\[
X_{i+1} = a X_i \space mod \space m
\]
上の条件より, 乗法合同法では最長周期 m は達成できないことがわかる.
m = \(2^e\) (e ≥ 4) の場合の乗法合同法の最長周期は次の条件のもとで \(2^{e-2}\) になる.
- \(X_0\) と m が互いに素である
- a mod 8 が 3 または 5 である
13.1.1.3 線形合同法のシード
最長周期を達成していない場合にはシードの値に制限が付く. これは, 達成される周期 (< m) の数列に含まれていない値をシードにしてはいけないためである. 例えば, m が 2 の累乗の乗法合同法では最良の周期でも m/4 であるからシードには制限がある. 特にシードを 0 にできないことは明らかであるから, 乗法合同法で得られる乱数列には 0 は含まれないことになる. この場合, シードは奇数にしなければならなくて, 生成される乱数も奇数である.
13.1.1.4 線形合同法の実装例
ここまで, 最長周期になる a, c および m の選び方を見てきたが, これだけではランダムにするための十分条件にはならない. 実際にどうやると良いものを選べるかは難しい問題であるが, 参考までに既存の乱数生成プログラムを調べてみる.
下表に線形合同法によるプログラムの例を示す.
| プログラム | 機種 | m | a | c | 周期 |
| RANDU | IBM 360/370 | 231 | 65539 (= 216 + 3) | 0 | 229 |
| Unix rand | Unix (V7 など) | 231 | 1103515245 | 12345 | 231 |
| rand (標準 C) | Windows (Visual C/C++ など) | 231 | 214013 | 2531011 | 231 (ただし, RAND_MAX = 215 – 1) |
| rand48 | Unix (System V など) | 248 | 25214903917 | 11 | 248 |
| Rnd | Excel VBA | 224 | 16598013 | 12820163 | 224 |
RANDU
IBM 360/370 メインフレームで広く使われた RANDU (FORTRAN 関数) は c = 0 を使用する乗法合同法である. a mod 8 = 3 となっており, 乗法合同法の最大周期 231-2 を達成している. しかし, この a の値では \(X_{k+2} = 6X_{k+1} – 9X_k (modulo \space 2^{31})\) が成り立ち, 生成される乱数列の引き続く 3 個の間に高い相関が生じるという問題が見つかっている. また, a が奇数, c = 0 であるから, 奇数の初期値では奇数だけが生成され, 偶数の初期値では偶数だけが生成される.
Unix rand
rand 関数は 古い Unix (V7 など) から使われている関数である. 32 ビット演算を行うが, 下位ビットの規則性の問題を避けるために, 符号を除いて上位 15 ビットが返される. a = 1103515245 (= 35 x 5 x 7 x 129749) と c = 12345 (= 3 x 5 823) は最長周期となる条件を満たす.
標準 C/C++ rand
Unix rand と同名の関数が標準 C/C++ にも規定されており現代の C/C++ コンパイラーにもある. 標準 C/C++ では実装はコンパイラー依存で, 整数乱数の最大値が RAND_MAX として定義されることになっている.
Windows では RAND_MAX = 215 – 1 (Visual C/C++ など) で, Unix rand と似ているが a と c の値は異なり, a = 214013 (= 17 x 12589) と c = 2531011 (= 7 x 17 x 21269) で, 最長周期となる条件を満たす.
現代の Linux (glibc) では RAND_MAX = 231 – 1 と定義され, 実際には後述の random が呼び出される.
rand48
Unix (System V など) において rand の後継として使われてきた rand48 は, m = 248 として周期を長くとったものであるが, 長いビット長の乗算が必要なため計算速度はやや遅くなる. a = 25214903917 (= 7 x 443 x 739 x 11003) と c = 11 は最長周期となる条件を満たす.
Rnd
VBA (Excel) の Rnd では m = 224 である. a = 16598013 (= 3 x 227 x 24373) と c = 12820163 (= 2293 x 5591) は最長周期となる条件を満たす.
13.1.2 ラグ付きフィボナッチ法
フィボナッチ数列は次の漸化式で生成される.
\[
X_i = (X_{i-1} + X_{i-2}) \space ただし, X_1 = X_2 = 1
\]
これに「ラグ」を持たせた次の漸化式で生成される数列をラグ付きフィボナッチ数列とよぶ.
\[
X_i = (X_{i-k} + X_{i-l}) mod m, \space i \ge k (k > l)
\]
k と l をラグ (遅れ) とよぶ. この数列では, m = 2e の場合の周期が 2(e-1)(2k – 1) と大きな値になる (l, k) 対が知られており, 次のようなものがある.
\[
(24, 55), (38, 89),(37, 100), (30, 127), (83, 258), (107, 378), (273, 607), \dots
\]
この数列の特長は, 周期が長く, 線形合同法と違い掛け算を含まないので計算速度的に有利なことである. ただし, 生成される数列のランダム性の理論はよくわかっていない.
Knuth の ran_array
Knuth の ran_array サブルーチン (文献 [1]) では, l = 37, k = 100, m = 230 を採用しており, 周期はおおよそ 2129 である. ただし, 次のように足し算ではなく引き算を使う.
\[
X_i = (X_{i-k} – X_{i-l}) \space mod \space m
\]
これを使う際には, 1009 個の乱数を生成し, そのうち最初の 100 個だけを採用することが推奨されている.
Unix の random
Unix (BSD など) には rand と rand48 の他に random という関数があるが, その実装にはこの方法が使われている.
\(X_i\) の過去値を保持するバッファのサイズを 8, 32, 64, 128 または 256 バイトに設定できる (5 種類の動作モードを選択できる). デフォルト値は 128 バイトで, そのときのパラメータは l = 3, k = 31, m = 231 で, 周期は 16 x (231 – 1) となる.
バッファ (過去値) の初期化には古い rand が使われている. なお, バッファサイズが 8 バイトの場合には線形合同法が使用され, 古い rand と同じ動作をする (ただし, RAND_MAX = 231 – 1 である).
13.1.3 メルセンヌ・ツイスター (MT)
超長周期で統計的性質がよい疑似乱数生成器である. 具体例として提示された MT19937 (周期 219937 – 1) は非常に高速である. これは, Python や C++11 などで標準乱数生成器として採用されていることでも知られている.
以下, その原理の大雑把な説明を試みるが, LFSR, GFSR, TGFSR そして MT と段階的に進める.
13.1.3.1 LFSR (線形帰還シフトレジスタ)
\(a_i\) は値が 0 または 1 の p 個のビット列とする.
\[
a_0, a_1, a_2, \dots, a_{p-1}
\]
これらをすべてが 0 ではないように任意に 0 または 1 に初期化しておき, i ≥ p として次の漸化式によりビット列を生成する.
\[
a_i = c_1 a_{i-1} + c_2 a_{i-2} + \dots + c_p a_{i-p} \space (modulo \space 2)
\]
ただし, \(c_1, c_2, \dots\) は 0 または 1 の係数である.
ここで, 次のような p 次の多項式を考える.
\[
1 + c_1 x + c_2 x^2 + c_3 x^3 + \dots + c_p x^p \space (modulo \space 2), \space ただし, c_p = 1
\]
これが p 次の原始多項式になるように p および係数を選ぶことができて, そのとき, ビット列 \(\{ a_i \}\) の周期は 2p – 1 になる. このようなビット列を線形最長周期列 (M 系列) とよぶ.
このようにして得られるビット列 \(\{ a_i \}\) からワード長ぶんを切り出して乱数列とするものを LFSR (線形帰還シフトレジスタ) 生成器とよぶ.
3.1.3.2 GFSR (一般化帰還シフトレジスタ)
ここで \(\{ a_i \}\) から w ビットを取り出した数列 \(\{ x_i \}\) を次のように定義する.
\[
x_i = ( a_{i+s_1} a_{i+s_2} \dots a_{i+s_w} )
\]
ただし, \(x_i\) は 0 または 1 の要素 w 個からなるベクトルで, w ビットのワードと捉えてよい.
\(s_1, s_2, \dots, s_l\) は互いに独立で n とは無関係な定数である. ただし, w = 32 (32 ビット/ワード) の場合には \(s_1 = 0, s_2 = 1, \dots, s_32 = 31\) としてよいことがわかっている.
このような数列 \(\{ x_i \}\) は \(\{ a_i \}\) と同様に次の漸化式を満たす.
\[
x_i = c_1 x_{i-1} + c_2 x_{i-2} + \dots + c_p x_{i-p} \space (modulo \space 2), \space ただし, c_p = 1
\]
ここで, 係数 \(c_i\) を \(c_q\) と \(c_p\) (q < p) 以外はすべて 0 になるように選ぶことができれば次式のようになる.
\[
x_i = x_{i-q} + x_{i-p} \space (modulo \space 2)
\]
このような q と p の組み合わせは存在することがわかっている.
なお, modulo 2 での + 演算はビットごとの XOR で行うことができ, 次のように表すことができる. 実際に計算を行うときには XOR 演算はきわめて高速である.
\[
x_i = x_{i-q} \oplus x_{i-p} \space (i = p, p+1, \dots)
\]
このようにして得られる数列を乱数列として使う方法は GFSR (一般化帰還シフトレジスタ) 生成器とよばれる.
なお, 論文等では (同等の) 次式で表されることが多いようである.
\[
x_{k+n} = x_{k+m} \oplus x_k \space (k = 0, 1, \dots)
\]
ただし, m および n は正の整数で n > m である.
3.1.3.3 TGFSR (ねじれ (Twisted) 一般化帰還シフトレジスタ)
TGFSR は, GFSR の漸化式を次のように変形したものである.
\[
x_{k+n} = x_{k+m} \oplus x_k A \space (k = 0, 1, \dots)
\]
ただし, \(A\) は要素が 0 または 1 の次のような w x w 行列である. w はワード長である.
\[
A =
\begin{pmatrix}
0 & 1 \\
& & 1 \\
& & & \ddots \\
& & & & 1 \\
a_0 & a_1 & a_2 & \dots & a_{w-2} & a_{w-1} \\
\end{pmatrix}
\]
この行列に対しては, シフト演算と XOR などのビット演算を用いて \(x_k A\) を高速に計算できる. また, \(A\) の特性多項式は次のようになる.
\[
\phi_A(t) = a_0 + a_1 t + a_2 t^2 + \dots + a_{w-1}t^{w-1} + t^w
\]
ここで, n, m および \(\phi_A(t)\) を, \(\phi_A\) の次数が w で, \(\phi_A(t^n + t^m)\) が原始多項式になるように選ぶと, この漸化式により生成される数列の周期は \(2^{nw} – 1\) に達する.
TGFSR には統計的性質上の問題が見つかっており, それを解決するために数列 \(\{x_i\}\) に次の変換を施した数列 \(\{z_i\}\) を用いる.
\[
\begin{align}
& y = x \oplus ((x << s) \space AND \space b) \\
& z = y \oplus ((y << t) \space AND \space c) \\
\end{align}
\]
s および t は整数で, 0 ≥ s, t ≥ w - 1 である. b および c は 1 ワード長のビットマスクである.
これをテンパリングとよぶ.
3.1.3.4 メルセンヌ・ツイスター (MT)
TGFSR の漸化式をさらに次のように変形する.
\[
x_{k+n} = x_{k+m} \oplus (x_k^u | x_{k+1}^l)A \space (k = 0, 1, \dots)
\]
\((x_k^u | x_{k+1}^l)\) は \(x_k\) の上位 w − r ビットと \(x_{k+1}\) の下位 r ビットを連結した行ベクトルを表す. ただし, 0 ≤ r ≤ w – 1 である. この漸化式により生成される数列の最大周期は \(2^{nw-r} – 1\) になる.
また, テンパリングを次のように変更する.
\[
\begin{align}
& y = x \oplus (x >> u) \\
& y = y \oplus ((y << s) \space AND \space b) \\
& y = y \oplus ((y << t) \space AND \space c) \\
& z = y \oplus (y >> l) \\
\end{align}
\]
u および l は整数である.
以上から, 周期に関するパラメータは w, n, m, r および a, テンパリングのパラメータは l, u, s, t, b および c である.
これらをうまく定めた実装例として論文で提示された MT19937 のパラメータ値は次のとおりである.
(w, n, m, r) = (32, 624, 397, 31)
a = 9908B0DF
u = 11
s = 7, b = 9D2C5680
t = 15, c = EFC60000
l = 18
周期は 2nw-r – 1 = 219937 – 1 で, これはメルセンヌ素数である.
ホームページ (文献 [4]) に詳しい説明とプログラムが掲載されている. なお, 論文発表後も開発が継続されており, その後のハードウェアに対応した改良版の SFMT (SIMD-oriented Fast Mersenne Twister) が 2007 年に発表されている. また, MT19937 の 64 ビット版も発表されている.
13.1.4 乱数の検定
生成された乱数列が良い乱数列であるかどうかを判定するための検定法は多数提案されている. Knuth の本 (文献 [1]) には種々の検定法が詳しく解説されている. また, いくつかの検定ツールが公開されている.
NIST (米国標準技術局) の検定ツール SP800-22
NIST の検定ツールがホームページ http://csrc.nist.gov/groups/ST/toolkit/rng/documentation_software.html からダウンロードして使用することができる (最新版は 2014 年 7 月版).
これを使用して上にあげたいくつかのプログラムを検定する. このツールの検定項目は次のとおりである.
| No. | 検定項目 | テスト数 |
| 1 | 1次元度数検定 (Frequency (Monobit) test) | 1 |
| 2 | ブロック単位の度数検定 (Frequency test within a block) | 1 |
| 3 | 連の検定 (Runs test) | 1 |
| 4 | ブロック単位の最長連検定 (Test for the longest run) | 1 |
| 5 | 2値行列ランク検定 (Binary matrix rank test) | 1 |
| 6 | DFT検定 (DFT spectral test) | 1 |
| 7 | 重なりのないテンプレート適合検定 (Non-overlapping template matching test) | 148 |
| 8 | 重なりのあるテンプレート適合検定 (Overlapping template matching test) | 1 |
| 9 | Maurer のユニバーサル統計検定 (Maurer’s universal statistical test) | 1 |
| 10 | 線形複雑度検定 (Linear complexity test) | 1 |
| 11 | 系列検定 (Serial test) | 2 |
| 12 | 近似エントロピー検定 (Approximate entropy test) | 1 |
| 13 | 累積和検定 (Cumulative sums test) | 2 |
| 14 | ランダム偏差検定 (Random excursions test) | 8 |
| 15 | 変形ランダム偏差検定 (Random excursions variant test) | 18 |
このツールはビット列を入力とするようになっている. そこで, 各乱数生成プログラムの整数値 (浮動小数に変換する前の値) をその有効なビット幅だけ取り出して, 桁の大きい方からのビット列を入力とした. ビット長 100 万ビットの標本 1000 本を乱数生成プログラムごとに用意した.
検定結果を下表に示す. ○ は項目をパスし, × はパスしなかったことを示す. テスト数が複数あるものについては, パスしなかったテストの数を示した.
| No. | 乗法合同法 | 線形合同法 | ラグ付きフィボナッチ法 | メルセンヌツイスター | ||||
| RANDU | Unix rand | rand (標準 C) | rand48 | VBA Rnd | random | ran_array | mt19937 | |
| 1 | × | ○ | ○ | ○ | ○ | ○ | ○ | ○ |
| 2 | × | ○ | ○ | ○ | ○ | ○ | ○ | ○ |
| 3 | × | ○ | ○ | ○ | × | ○ | ○ | ○ |
| 4 | × | ○ | ○ | ○ | × | ○ | ○ | ○ |
| 5 | ○ | ○ | ○ | ○ | ○ | ○ | ○ | ○ |
| 6 | × | × | × | ○ | × | ○ | ○ | ○ |
| 7 | ×137/148 | ○ | ○ | ×1/148 | ×147/148 | ○ | ○ | ○ |
| 8 | × | ○ | ○ | ○ | × | ○ | ○ | ○ |
| 9 | × | ○ | ○ | ○ | × | ○ | ○ | ○ |
| 10 | ○ | ○ | ○ | ○ | ○ | ○ | ○ | ○ |
| 11 | × | ○ | ○ | ○ | × | ○ | ○ | ○ |
| 12 | × | ○ | ○ | ○ | × | ○ | ○ | ○ |
| 13 | × | ○ | ○ | ○ | × | ○ | ○ | ○ |
| 14 | ×8/8 | ○ | ○ | ○ | ○ | ○ | ○ | ○ |
| 15 | ×18/18 | ×1/18 | ○ | ○ | × | ○ | ○ | ○ |
・rand (標準 C) は Windows の Visual C を使用した.
・rand48, ranarray および mt19937 は XLPack (Windows) を使用した. rand48 では mrand48 (32 ビット整数), mt19937 では genrand_int32 (32 ビット整数) を使用した.
・VBA Rnd は Windows の Office 365 を使用した.
・random は Linux (ubuntu 26.04) を使用した.
RANDU と VBA Rnd はかなり成績が悪かった. RANDU はすでに使われていないが, VBA の Rnd は周期も短く, 統計的性質が問題になるような用途への適用は控えた方がよい.
古い Unix rand と Windows (Visual C) の rand はこの検定では思っていたより良い結果であった. これは, 下位 16 ビットを捨て, 上位 15 ビットしか使っていないためかもしれない. しかし, Windows の Visual C の rand を使用する際には 15 ビットの精度しかないことを意識しておいた方がよい.
rand48, Random, ranarray などは問題点の指摘もあるようだが, この検定の範囲では良い成績であった.
3 次元空間での分布のプロット
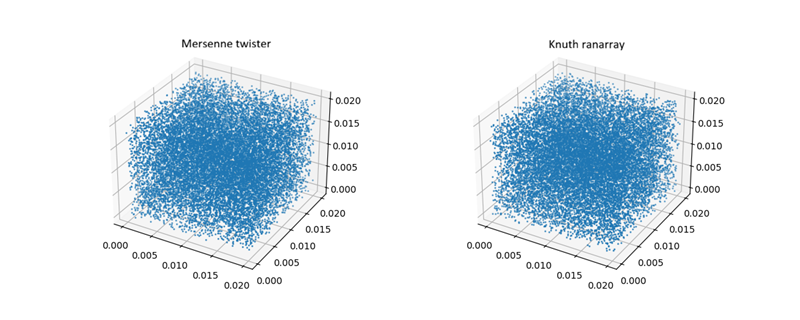
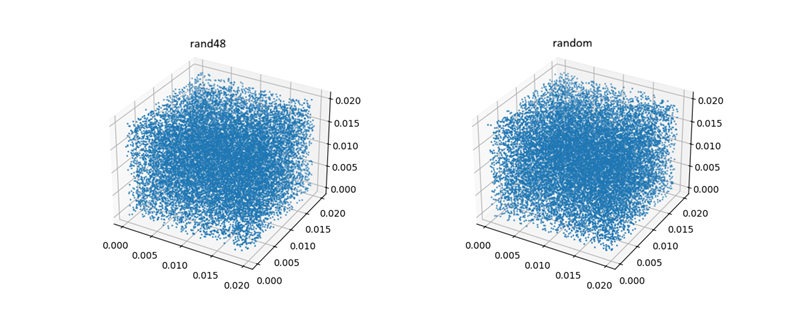
生成された乱数列の 3 次元空間での分布を次の手順によりプロットする.
- 乱数 (値を 0.0 ~ 1.0 の実数に変換) を 3 つ生成し, それらを xyz 座標とする点を単位立方体にプロットする.
- これを 231 回繰り返す. ただし, VBA Rnd では 224 回とした.
- 単位立方体の原点付近の一辺 0.02 (ただし, VBA Rnd では 0.1) の立方体にプロットされた点を表示する.
結果は次のようになった.
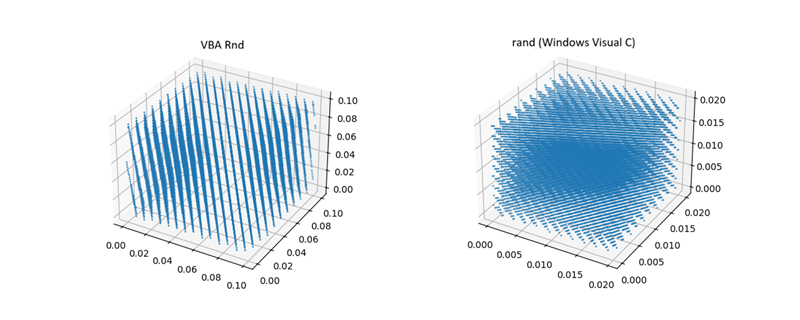
VBA Rnd でははっきりと構造が見えて, 平行な平面の上にのっていることがわかる. rand (Windows Visual C) は VBA Rnd と同じ条件ではランダムなプロットに見えたが, サンプル数 (回数) を 231 に増やし, プロットする領域を一辺 0.1 から 0.02 に小さくすると図のように構造が見えた. 明らかにランダム性に問題があると言える.
他の生成器 (メルセンヌツイスター, ranarray, rand48, random) では個のプロットではランダムに見える. NIST のスペクトル検定でも合格しているのでよさそうだが, それぞれの周期に近いもっと大きなサンプル数でやってみたいところではある.
Excel VBA で使用する Rnd や XLPack では, 乱数の生成速度も遅く, 統計的性質が問題になるような大規模な使い方はされないと思うが, ここで説明した内容は理解しておいた方がよい.


