13.2 種々の分布に従う乱数
13.2.1 概要
一様分布以外の分布に従う乱数を直接生成する良い方法はまだなく, 一様乱数を生成してそれから間接的に他の分布に従う乱数を求めるのが一般的である.
ここでは連続分布の場合について, 代表的な解法を説明する.
離散分布を含む詳細な確率分布乱数生成法については文献 [3] を参照するとよい.
13.2.1.2 確率分布関数と確率密度関数
確率変数を \(X\) とすると, 分布関数 \(F(x)\) は \(X\) が \(x\) を超えない確率 (\(P\)) を表す.
\[
F(x) = P(X \le x)
\]
\(F(x)\) は広義単調増加関数 (\(x_1 \lt x_2\) ならば \(F(x_1) \le F(x_2)\)) で, \(0 \le F(x) \le 1\) である.
次式を満たす関数 \(f(x)\) を確率密度関数という. \(f(x) \ge 0\) である.
\[
F(x) = \int_{-\infty}^x f(t) dt
\]
例. 指数分布
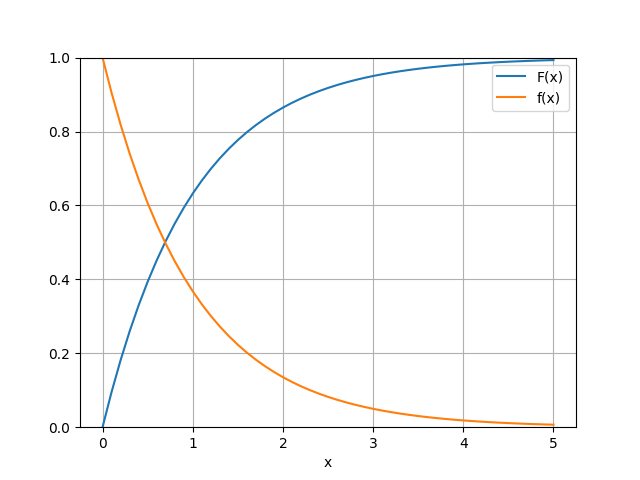
指数分布は確率密度関数が次式で与えられる分布である.
\[
f(x) = \frac{1}{\theta} exp(-\frac{x}{\theta}), \space (x \ge 0, \space \theta \gt 0)
\]
ここで, θ はパラメータである. θ = 1 のときを標準指数分布という.
これを積分して分布関数は次のように求められる.
\[
F(x) = \int_0^x f(t) dt = 1 – exp(-\frac{x}{\theta}), \space (x \ge 0, \space \theta \gt 0)
\]
標準指数分布の \(F(x)\) と \(f(x)\) をグラフで表すと次のようになる.
13.2.2 一般的な乱数生成法
13.2.2.1 逆関数法
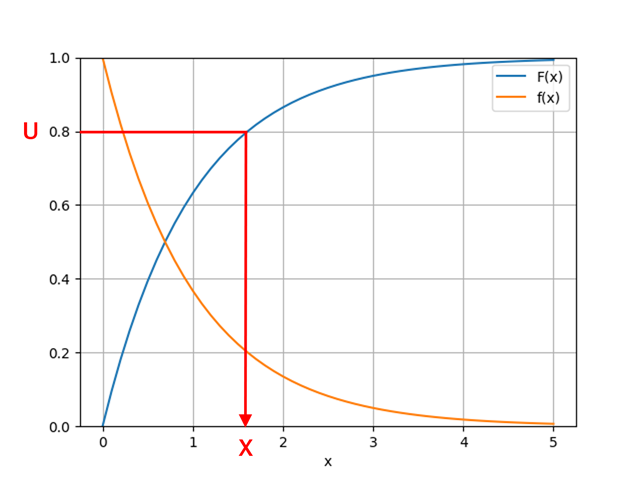
分布関数の逆関数 \(F^{-1}(x)\) を求めることができるならば, \(U\) が一様乱数であれば次式により分布関数 \(F(x)\) をもつ乱数 \(X\) を生成することができる.
\[
X = F^{-1}(U)
\]
分布関数の逆関数が容易に計算できるなら, この方法により一様乱数を一様分布以外の分布に従う乱数に変換することができ, これを逆関数法という.
例. 指数分布への適用例
\(u = F(x)\) とおいて \(x\) について解くと逆関数が求められる.
\[
F^{-1}(x) = -\theta ln(1 – u), \space (0 \ge u \gt 1)
\]
一様乱数 U を発生させ \(X = -\theta ln(1 – U)\) とすることで, 指数分布に従う乱数 X を生成することができる. これを図示すると次のようになる.
13.2.2.2 棄却採択法
所望の分布の確率密度関数を \(f(x)\) とする. それと定義域が同じで容易に生成できる乱数の確率密度関数を \(g(x)\) とし, 定数 c が定義域内で次式を満たすものとする.
\[
f(x) \le c \cdot g(x)
\]
このとき, 以下の手順により分布 \(f(x)\) に従う乱数を生成することができ, これを棄却採択法という.
- \(g(x)\) に従う乱数 x を生成する
- 区間 (0, 1) の一様乱数 u を生成する
- \(u \le f(x)/(c \cdot g(x))\) であれば x を採用する
- そうでなければ, ステップ 1 からやり直す
ただし, この方法では採用される割合が小さいと精度が落ちるため \(g(x)\) の選び方には注意が必要である.
例. 指数分布への適用例
指数分布を表す上図において, \(x = 5\) における \(F(x)\) の値は 0.993 と十分大きな値であるから, 定義域を [0. 5] で近似することにする. そして \(g(x)\) として [0, 5] の一様分布を使うと, \(c = 5\) となる.
従って, x と u を生成し, \(u \le f(x)\) であれば x を採用すればよい.
13.2.2.3 圧搾法
棄却採択法では確率密度関数 \(f(x)\) の計算が必要であるが, その計算は複雑で時間がかかることがあるので, それが必要になる頻度を減らすような改良を加えた方法である.
生成したい乱数の \(f(x)\) に対して, 定義域で次の条件を満たし計算が容易な関数 \(h_1, h_2\) を考える.
\[
0 \ge h_1(x) \ge f(x) \ge h_2(x) \ge c \cdot g(x)
\]
そして, 棄却採択法のアルゴリズム中の判定 \(u \le f(x)/(c \cdot g(x))\) の代わりに \(u \le h_1(x)/(c \cdot g(x))\) を満たせば x を採用することにする. また, \(u \gt h_2(x)/(c \cdot g(x))\) であれば x を棄却することにする. どちらでもないときにだけ判定 \(u \le f(x)/(c \cdot g(x))\) を行うことにする.
このようにすると計算に時間がかかる \(f(x)\) の計算頻度を減らすことができる.
13.2.3 代表的な分布の乱数生成法
ある分布の乱数を生成したいときに, 一般的な乱数生成法が適用できればよいが, 逆関数が求められない場合や棄却採択法がうまく使えない場合には他のやり方を工夫する必要がある. また, 分布ごとに特有の効率の良いやり方が知られている場合もある.
以下, 代表的な分布ごとに, 使用される乱数生成法を説明する.
13.2.3.1 正規分布
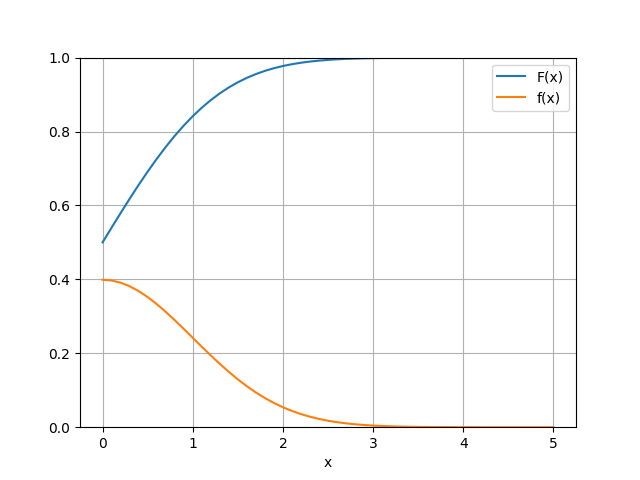
標準正規分布 (平均 0, 標準偏差 1) の確率密度関数は次式で与えられる.
\[
f(x) = \frac{1}{\sqrt{2\pi}} exp(\frac{-x^2}{2})
\]
分布関数は次のようになる.
\[
\begin{align}
F(x) & = \frac{1}{\sqrt{2\pi}} \int_{-\infty}^x exp(\frac{-t^2}{2}) dt \\
& = \frac{1}{2}(1 + erf(\frac{x}{\sqrt{2}})) \\
\end{align}
\]
ここで, erf() は誤差関数である.
グラフで表すと次のようになる.
この分布関数の逆関数の計算は難しく, 逆関数法は使えない. そのため, いくつかの方法が考えられている.
なお, 標準正規乱数 (標準正規分布に従う乱数) X (平均 0, 標準偏差 1) は, 次式により平均 μ, 標準偏差 σ の任意の正規乱数 (任意の正規分布に従う乱数) Y に変換することができる.
\[
Y = \mu + \sigma X
\]
すなわち, 標準正規乱数が生成できればよい.
13.2.3.1.1 Box-Muller 法
アルゴリズムが簡便でよく使われる方法が Box-Muller 法である. この方法では, 2 つの一様乱数 \(U_1, U_2\) を生成して次の変換を行うことにより 2 つの独立した標準正規乱数 \(Y_1, Y_2\) を得ることができる. (詳細は文献 [3] 参照)
\[
\begin{align}
& Y_1 = \sqrt{-2 ln(U_1)} cos(2\pi U_2) \\
& Y_2 = \sqrt{-2 ln(U_1)} sin(2\pi U_2) \\
\end{align}
\]
この方法について対数や三角関数の計算を避けるなどの改良を行ったものが Polar 法 とよばれている. なお, Knuth の文献 [1] では Algorithm P と表記されている.
13.2.3.1.2 Ziggurat 法
棄却採択法の一種で, 高速で精度がよい方法である. (詳細は文献 [3] 参照)
この方法は Python の Numpy でも採用されている.
確率密度関数 \(f(x)\) の左側を覆う n 個の等面積の長方形 (一番下だけは右側の裾を含む) を積み重ねて全体を覆う. 図に n = 8 の例を示す (実用的には n = 128, 256 などが使われる).
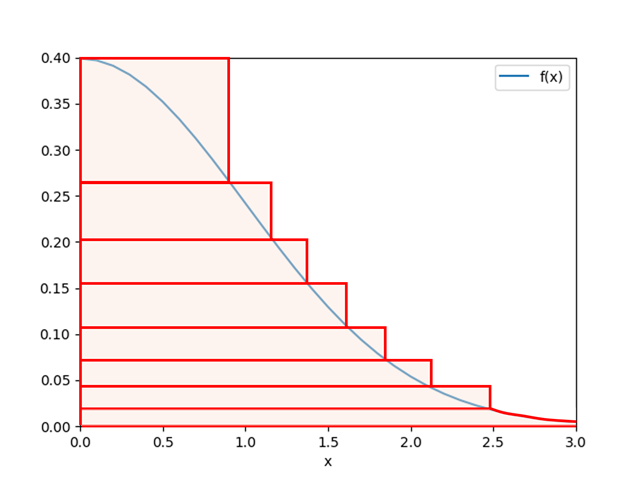
乱数を発生させるには, ランダムに 1 つの長方形を選び, その中でランダムに 1 点を選び \(f(x)\) の下に入ればその x 座標を目的の乱数として採用する. 裾の部分を含む一番下が選ばれたときは特別な扱いが必要になる.
この方法は x > 0 において \(f(x)\) が単調減少する分布に適用できる. 標準正規分布は x = 0 について左右対称で x > 0 において単調減少するので, この方法を x > 0 において適用し半分の確率で符号が負になるようにすればよい.
13.2.3.2 指数分布
13.2.2.1 の例に示したように, 逆関数法 (13.2.2.1) を使用して指数分布に従う乱数 (指数乱数) を生成することができる.
しかし, Ziggurat 法 (13.2.3.1.2) を適用することもでき, 逆関数法よりも高速に指数乱数を生成することができる.
13.2.3.3 ガンマ分布
ガンマ分布の確率密度関数は次式で与えられる.
\[
f(x) = \frac{\beta^{-\alpha} x^{\alpha -1} e^{-x/\beta}}{\Gamma(\alpha)} \space (0 \lt x \lt \infty, \space \alpha \gt 0, \space \beta \gt 0)
\]
また, 分布関数は次式で与えられる.
\[
F(x) = \frac{\gamma(\alpha, x/\beta)}{\Gamma(\alpha)}
\]
\(\Gamma()\) はガンマ関数, \(\gamma()\) は第1種不完全ガンマ関数である. α は形状母数, β は尺度母数とよばれるパラメータである.
\(\beta = 1\) のガンマ分布の確率密度関数 \(f(x)\) および分布関数 \(F(x)\) のグラフを α = 0.5, 1, 1.5 について以下に示す.
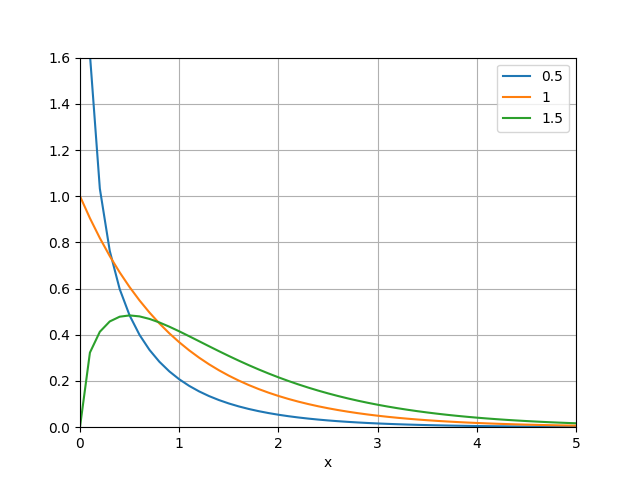
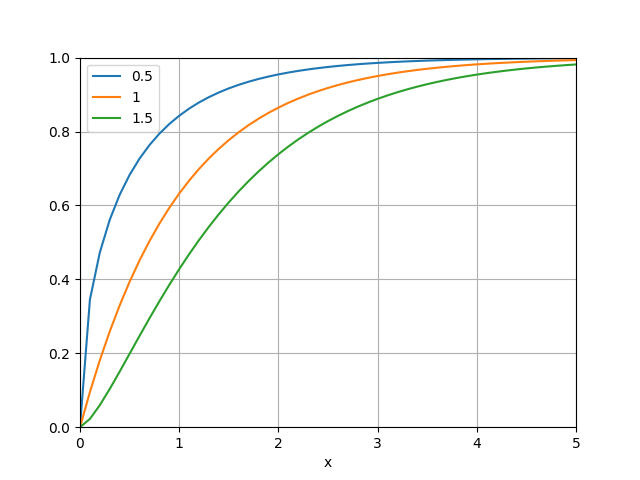
図からわかるように, ガンマ分布は α の値 (0 < α < 1, α = 1, α > 1 の 3 パターン) により分布の形状が異なる.
ガンマ分布を \(\Gamma(\alpha, \beta)\) と表記する. \(\beta = 1\) のガンマ分布 \(\Gamma(\alpha, 1)\) は標準ガンマ分布とよばれる. ガンマ分布 \(\Gamma(\alpha, \beta)\) に従う確率変数 X は標準ガンマ分布に従う確率変数 Y から次のようにして変換することができる.
\[
X = \beta Y
\]
従って, 標準ガンマ分布 \(\Gamma(\alpha, 1)\) に従う乱数 X が生成できれば, ガンマ分布 \(\Gamma(\alpha, \beta)\) に従う乱数 Y に変換できる.
α = 1 のとき, 標準ガンマ分布 \(\Gamma(1,1)\) は標準指数分布に一致する.
0 < α < 1 の場合には, \(\Gamma(\alpha + 1)\) に従う乱数 \(Y_{\Gamma(\alpha+1,1)}\) とそれとは独立な (0, 1) における一様乱数 \(U\) から, 次式により必要な乱数を生成することができる.
\[
Y_{\Gamma(\alpha,1)} = Y_{\Gamma(\alpha+1,1)} U^{1/\alpha}
\]
以上から, α > 1 の標準ガンマ分布に従う乱数が生成できればよいことになる.
13.2.3.3.1 標準ガンマ分布に従う乱数の生成
標準ガンマ分布の確率密度関数から逆関数を求めるのは難しいので, 棄却採択法が使用される. 多くの文献で生成法が提案されているが, 文献 [3] に詳しく解説されている α > 1 の標準ガンマ分布に従う乱数を生成する方法 (アルゴリズム 3.60) を簡単に紹介する. この方法は XLPack で採用している.
標準ガンマ分布の確率密度関数 \(f_{\Gamma(\alpha, 1)}(x)\) に変数変換 \(Y = h(Z)\) を施すと次の確率密度関数 \(f_Z\) が得られる.
\[
f_Z(z) = f_{\Gamma(\alpha, 1)}(h(z))|h'(z)| = \frac{(h(z))^{\alpha-1}e^{-h(z)}|h'(z)|}{\Gamma(\alpha)}
\]
変換 h として次式を採用する.
\[
h(z) = d(1 + cz)^k, \space (-1/c \lt z \lt \infty, d \gt 0, c \gt 0, k \in N)
\]
ここで, \(f_Z\) が標準正規分布の確率密度関数 \(f_{N(0,1)}(z) = (1/\sqrt{2\pi})e^{-z^2/2}\) に近くなるように d, c, k を決める. 具体的には, \(d = \alpha – 1/3\), \(c = 1/\sqrt{9d}\), k = 3 とする.
標準正規分布に従う乱数 Z を生成して棄却採択法を適用する. Z は Ziggurat 法などで高速に生成できる. 棄却採択は, \(Z \gt -1/c\) のときに, Z に独立な一様乱数 u が \(u e^{-Z^2/2} \le e^{g(Z)}\) を満たすかどうかで判定する. ただし, \(g(z) = d ln(1 + cz)^3 – d(a + cz)^3 + d\) である. このようにすると, 採択率が非常に高くなり効率がよい.
さらに, \(g(z)\) の計算に含まれる対数計算を減らすため \(s(z) \le e^{g(z)} \le e^{-z^2/2}\) として圧搾法を適用する. ここで, \(s(z) = (1 – 0.0331z^4)e^{-z^2/2}\) が使用される.
13.2.4 統計的検定
ここに n 個の生成された乱数 \(X_1, X_2, \dots, X_n\) のサンプルがあるものとする. これがある確率分布に従うとみなせるのかどうか, その適合度を検定する方法について説明する.
13.2.4.1 Kolmogorov-Smirnov 検定 (KS 検定)
連続分布の場合 (例えば, 0 から 1 の実数乱数の場合) には Kolmogorov-Smirnov 検定 (KS 検定) が用いられる.
次式で与えられる \(F_n(x)\) をサンプルの経験分布関数という.
\[
F_n(x) = \frac{1}{n} (x 以下の X_i の数)
\]
これを用いて次の統計量を計算する.
\[
\begin{align}
& K_n^+ = \sqrt{n} \space max_{-\infty \lt x \lt +\infty} (F_n(x) – F(x)) \\
& K_n^- = \sqrt{n} \space max_{-\infty \lt x \lt +\infty} (F(x) – F_n(x)) \\
\end{align}
\]
ここで, \(F_n(x)\) は \(X_i\) を昇順に並べ替えてからその個数を小さい方から数えて算出するので, この計算は \(X_i\) が昇順に並んでいるとして次のように簡単な形にすることができる.
\[
\begin{align}
& K_n^+ = \sqrt{n} \space max_{1 \le j \le n} (\frac{j}{n} – F(X_j)) \\
& K_n^- = \sqrt{n} \space max_{1 \le j \le n} (F(X_j) – \frac{j – 1}{n}) \\
\end{align}
\]
\(K_n^+\) と \(K_n^-\) の値が小さいほどサンプルが \(F(x)\) の分布に従うとみなすことができる. その具体的な値は, 小さい n については, 文献 [1] に表が示されている. n が大きい場合には次式により近似値を求めることができる.
\[
K_n^+ = K_n^- = y_p – \frac{1}{6}n^{-1/2} + O(1/n), \space ただし \space y_p^2 = \frac{1}{2}ln(1/(1 – p))
\]
p は有意水準を表す.いくつかの p について \(y_p\) の値を求めると次のようになる.
| 1 % | 5 % | 10 % | 25 % |
| 0.07089 | 0.1601 | 0.2295 | 0.3793 |
例. 指数分布
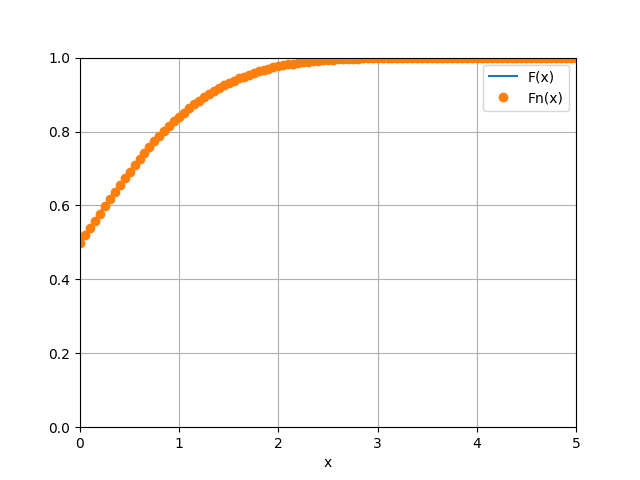
XLPack の GenrandExp() (Ziggurat 法, メルセンヌツイスター) を使って 10,000 個の標準指数乱数を生成し, その \(F_n(x)\) をプロットすると次のようになった.
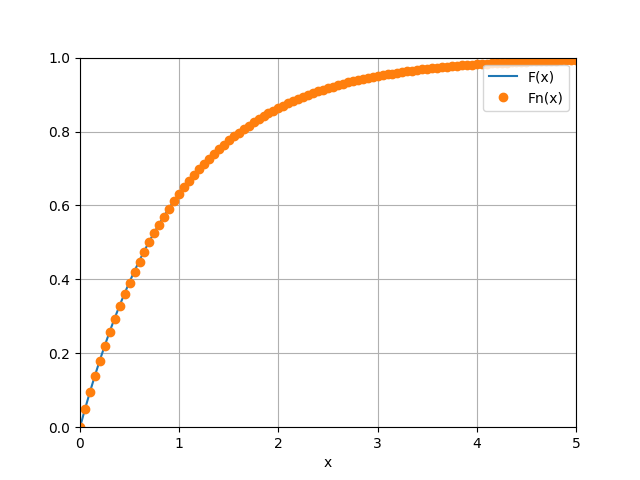
KS 検定の値は次のようになった.
\[
K_n^+ = 0.00582, \space K_n^- = 0.03413
\]
これは, 有意水準を 1 % よりかなり小さくとっても棄却されない値である.
例. 正規分布
XLPack の GenrandNorm() (Ziggurat 法, メルセンヌツイスター) を使って 10,000 個の標準正規乱数を生成し, その \(F_n(x)\) をプロットすると次のようになった.
KS 検定の値は次のようになった.
\[
K_n^+ = 0.00984, \space K_n^- = 0.01929
\]
例. ガンマ分布
XLPack の GenrandGam() (圧搾法, メルセンヌツイスター) を使って 10,000 個の標準ガンマ乱数 (α = 1.5) を生成し, その \(F_n(x)\) をプロットすると次のようになった.
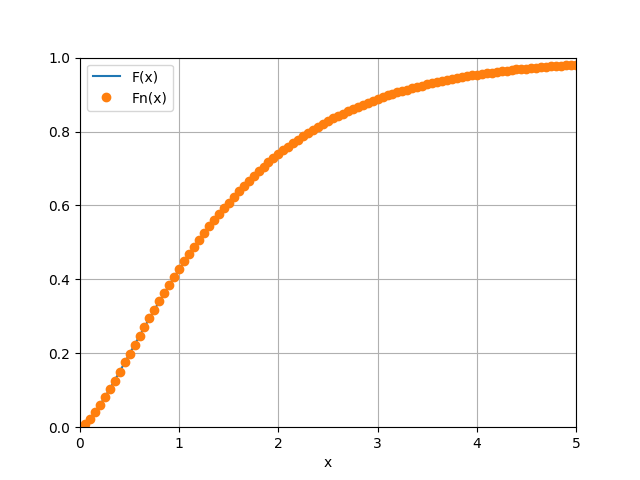
KS 検定の値は次のようになった.
\[
K_n^+ = 0.01150, \space K_n^- = 0.00666
\]


